现充|junyu33

(已完结)概统笔记

顺便用作LATEX练习.

成绩分布

卷面成绩:50%

平时成绩:50%

特点

概率部分

概率论基础

用A,B,C等表示事件

A―表示A的对立事件(对立是互斥的充分条件)

AB=A∩B

A−B=AB―=A−AB

A∩B―=A―∪B―

A∪B―=A―∩B―

发生B后再发生A的概率P(A|B)=P(AB)P(B),其中P(B)>0

全概率公式:设B1,...,Bm为完备事件组,则P(A)=∑i=1mP(A|Bi)P(Bi)

贝叶斯公式:设B1,B2...Bm为完备事件组,则P(Bi|A)=P(BiA)P(A)=P(Bi)P(A|Bi)∑i=1mP(A|Bi)P(Bi),即贝叶斯公式是乘法公式与全概率公式的组合。

若P(AB)=P(A)P(B),则A,B独立,同时A,B―、A―,B―、A―,B也独立。

二项分布概率:P(k)=Cnkpk(1−p)n−k

多项分布:某随机实验如果有k种可能的结果C1∼Ck,它们出现的概率是p1∼pk。在N随机试验的结果中,分别将C1∼Ck的出现次数记为随机变量x1∼xk,那么C1出现x1次、C2出现x2次……Ck出现xk次这种事件发生的概率是

N!x1!x2!...xk!p1x1p2x2...pkxk,其中∑i=1kxi=N,∑i=1kpi=1

随机变量及其分布(背)

随机变量X(ω)是一个函数,其中ω是样本空间,X是样本空间到实数的映射。

分布函数F(x)=P(X≤x),其定义域为R,非严格单增(左极限为0,右极限为1),右连续。

密度函数f(x) 满足 F(x)=∫−∞xf(x)dx

当f(x)连续时,可简化为F′(x)=f(x)。有f(x)≥0且∫−∞∞f(x)dx=1.

求概率的问题可以转化为概率密度函数的积分:P(X∈G)=∫Gf(x)dx.

非连续分布

几何分布与超几何分布略去.

二项分布:X∼B(n,p),P(X=k)=Cnkpk(1−p)n−k

二项分布的图像是单峰的,由于

P{X=k}P{X=k−1}=1+(n+1)p−kkq,故k最靠近(n+1)p时易得最值.

泊松分布:X∼P(λ),P(X=k)=λkk!e−λ

泊松分布相当于对ex的泰勒展开各项之和归一化.

泊松定理:二项分布以泊松分布为极限分布.具体而言, 对于X∼B(n,p),当n足够大时(>=100),我们可以近似把它看作X∼P(λ),其中λ=np

连续分布

均匀分布(uniform distribution)

f(x)={1b−ax∈[a,b]0others,x∼U(a,b)

指数分布(exponential)

f(x)={λe−λxx>00others,x∼e(λ)

伽马分布(gamma distribution)

f(x)={βαΓ(α)xα−1e−βxx>00others,x∼Γ(α,β)

Γ(x)=∫0∞tx−1e−tdt

随机变量函数的分布Y=f(X)型题目的做法

以求密度函数f(x)为例:

对于某些需要分类讨论的题目:

注意求积分+C时需要注意一下分布函数的连续性.

多(二)维随机变量及其分布

二维离散型随机变量分布

就是一个所有项和为1的表,没啥说的,求概率就是把对应位置的概率加起来就行。

边缘分布:

条件分布律:

二维连续型随机变量分布

相当于求二重积分,需要注意积分的定义域。

通常会利用定义域内积分和为1的性质求参数,然后重新求指定区域的二重积分来求概率。

二维分布函数与密度函数:F(x,y)=P(X≤x,Y≤y)=∫−∞x∫−∞yf(u,v)dudv

P(x1<X≤x2,y1<Y≤y2)=F(x2,y2)−F(x1,y2)−F(x2,y1)+F(x1,y1)

边缘密度:

条件分布函数:

常见题型:

一个密度、两个条件、两个边缘

  • 已知一个密度,求剩下四个。
  • 已知一个条件与对应的边缘,求剩下三个。

已知二维密度函数f(x,y),Z=g(X,Y),求Z的密度函数fZ(z)

  • 确定f(x,y)的有效区间R
  • 计算FZ(z)=∬(x,y)∈Rf(x,y)dxdy,注意分类讨论
  • 对z求导得到密度函数fZ(z)

卷积再见

若Z=max(X,Y)且X,Y独立,则FZ(z)=FX(z)FY(z)

若Z=min(X,Y)且X,Y独立,则FZ(z)=1−(1−FX(z))(1−FY(z))

数学期望

数学期望的定义

离散变量的期望:E(X)=Σk=1∞xkPk

连续变量的期望:E(X)=∫−∞∞xf(x)dx

当级数的和(或积分)绝对收敛时,数学期望存在。

对于二维的情况,还可以这样算:

E(X)=∫−∞∞xfX(x)dx

E(Y)=∫−∞∞yfY(y)dy

随机变量函数的期望

E(g(x))=Σk=1∞g(xk)Pk=∫−∞∞g(x)f(x)dx

E(g(x,y))=ΣΣg(xi,yj)Pij=∫−∞∞∫−∞∞g(x,y)f(x,y)dxdy

数学期望的性质

E(C)=C

E(C1X+C2Y)=C1E(X)+C2E(Y)

若X与Y独立,则E(XY)=E(X)E(Y)

方差

方差的定义

D(X)=E(X−E(X))2=E(X2)−E(X)2

设E(X)=c,

=E(X−c)2=E(X2−2cX+c2)

=E(X2)−2cE(x)+c2

=E(X2)−c2=E(X2)−E(X)2

标准差为D(X)

方差的性质

D(C)=0

D(aX)=a2D(X)

当X,Y独立时,D(X±Y)=D(X)+D(Y)

当X,Y独立时,D(Σi=1nciXi)=Σi=1nci2D(Xi)

D(X)=0⟺∃c,P(X=c)=1,但这不意味着X=c(同:概率为1的事件不一定是必然事件)

变异系数:Cv=D(X)|E(X)|

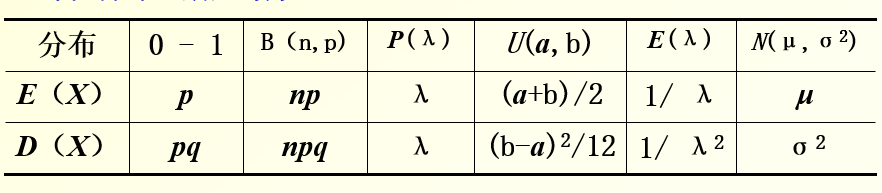
常见分布的期望与方差(背)

E(Γ(α,β))=αβ,D(Γ(α,β))=αβ2

原点矩与中心矩

mk=E(Xk)

μk=E(X−E(X))k

因此方差是二阶中心矩。

协方差与相关系数

协方差的定义

Cov(X,Y)=E((X−EX)(Y−EY))=E(XY)−E(X)E(Y)

证明与方差类似,此略

协方差的性质

Cov(X,X)=D(X)

Cov(X,Y)=Cov(Y,X)

Cov(X,a)=0

Cov(aX,bY)=abCov(X,Y)

Cov(X+Y,Z)=Cov(X,Z)+Cov(Y,Z)

D(X±Y)=D(X)+D(Y)±2Cov(X,Y)

若X与Y独立,则Cov(X,Y)=0

证明:显然由期望的性质可得。

由此可证若X与Y独立,D(X±Y)=D(X)+D(Y)

随机变量的标准化

X∗=X−E(X)D(X)

其期望为0,方差为1,没有量纲。

相关系数的定义(背)

相关系数(X,Y)=Cov(X∗,Y∗)=1D(X)1D(Y)Cov(X,Y)

显然X,Y不能为常数

相关系数需要计算五个期望:E(X),E(Y),E(X2),E(Y2),E(XY)

即R(X,Y)=E(XY)−E(X)E(Y)E(X2)−E(X)2E(Y2)−E(Y)2

相关系数的性质

0≤|R(X,Y)|≤1

当R(X,Y)=1时,∃t0>0,P(Y=t0X)=1,即X,Y正相关。

当R(X,Y)=−1时,∃t0<0,P(Y=t0X)=1,即X,Y负相关。

R(X,Y)=0表明X,Y不相关,是X,Y独立的必要条件。

如果要证明X,Y不独立,应选取合适的区间,使P(X,Y)≠P(X)P(Y)

正态分布

标准正态分布

N(0,1)=φ(x)=12πe−x22,x∈R

偶函数,钟形曲线。

Φ(x)=∫−∞xφ(x)dx

Φ(0)=12

Φ(x)+Φ(−x)=1

考试算概率时经常用这两个性质,并且应保留Φ(x)而不是Φ(−x)作为答案(或查表)。

正态分布

因X−μσ∼N(0,1),则X∼N(μ,σ2),故F(x)=Φ(x−μσ)

求导可得N(μ,σ2)=1σ2πe−(x−μ)22σ2,x∈R

μ关系到图象的左右平移(期望),σ关系到图象“尖”的程度(标准差)。

多个独立正态分布的线性组合还是正态分布。

特别的,如果它们都是N(μ,σ2),其平均值为N(μ,σ2n)

二维正态分布

特殊情况:

(X,Y)∼(μ1,μ2;σ12,σ22)=N(μ1,σ12)N(μ2,σ22)

一般情况(含相关系数):

(X,Y)∼(μ1,μ2;σ12,σ22;r)

=1σ1σ22π1−r2e−12(1−r2)((x−μ1σ1)2+(y−μ2σ2)2−2(x−μ1σ1)(y−μ2σ2)r)

对二维正态分布而言,其边缘分布与条件分布是正态分布。同时,不相关与独立性是等价的。

自然指数分布族

f(x,θ)=eθx−φ(θ)h(x)

常见分布中除了均匀分布均可化成这种形式。

其均值参数(期望m)为φ′(θ),方差函数为φ(2)(θ)

极限定理

切比雪夫不等式

P(|X−E(X)|≥ε)≤D(x)ε2

P(|X−E(X)|<ε)≥1−D(x)ε2

大数律

随机变量序列{Xn},考虑均值X―,

若X―−E(X―)⟶P0 ,则{Xn}服从大数律。

充要条件是随机变量的方差一致有界,即有常数C,使D(Xk)≤C 即可满足符合大数律。

只要Xk独立同分布,且E(Xk)=μ,D(Xk)=σ2即可保证符合大数律。

Xk∼B(n,p),则nAn⟶Pp

中心极限定理

Xi独立同分布,则 Zn=Σi=1nXi 近似服从正态分布。

E(Xk)=μ,D(Xk)=σ2→P(nX―−nuσn≤x)=Φ(x)

可得Z近似服从N(nμ,nσ2),X―近似服从N(μ,σ2n)

设X∼B(n,p),若Zn=Σi=1nXi

limn→∞P(Xn−npnpq≤x)=Φ(x)

即Z近似服从N(np,npq)

统计部分

常见分布

卡方分布——正态平方和

正态分布Xi∼N(0,1)的平方和。

χ2=Σi=1nXi2服从自由度为n的χ2分布,即χ2(n)

χ2(n)=Γ(n2,12),故E(χ2)=n,D(χ2)=2n

卡方分布满足可加性。

t分布——正态比一个数

X∼N(0,1),Y∼χ2(n)

t(n)=XYn

分布与正态分布相似,但尾巴比正态分布更厚。

F分布——正态平方和相比

X∼χ2(n),Y∼χ2(m)

F(n,m)=X/nY/m

1F=F(m,n)

常见统计量

样本均值

X―=1nΣi=1nXi

样本方差

S2=1n−1Σi=1n(Xi−X―)2(注意是n-1,不是n)

抽样分布定理

其一(已知方差)

样本X1,X2,...,Xn来自N(μ,σ2),则

χ2=(n−1)S2σ2=1σ2Σ(Xi−X―)2∼χ2(n−1)

且X―与χ2独立。

其二(已知均值)

样本X1,X2,...,Xn来自N(μ,σ2),则

t=X―−μS1n∼t(n−1)

其三(多个整体)

概统成功变成了文科

若X∼N(μ1,σ2),Y∼N(μ2,σ2)则,

X―−Y―∼N(μ1−μ2,σ12n1+σ22n2)

(n1−1)S12+(n2−1)S22σ2=χ2(n1+n2−2)

(X―−Y―)−(μ1−μ2)Sw1n1+1n2∼t(n1+n2−2)

其中Sw2=(n1−1)S12+(n2−1)S22n1+n2−2

若X∼N(μ1,σ12),Y∼N(μ2,σ22)则,

S12/σ12S22/σ22∼F(n1−1,n2−1)

点估计

矩估计

设样本均值与期望函数(也可以是平方期望)相等,把期望函数的参数θ用期望值m表示得到θ(m),然后将m代入x―得到θ^=θ(x―)。

极大似然估计

离散型:写出观测事件发生概率关于参数θ的函数(通常是某种离散分布的乘积),假设该函数为函数的最大值。通过求解对数极大似然方程dL(x)d(θ)=0的解得到对应的参数θ^.

连续型:取的函数应为∏i=1nf(xi,θ),注意这里把xi按常数看待,以下步骤相同。

极大似然估计值是xi的最大值,极大似然估计量是Xi的最大值。

估计量评选标准

无偏估计量:估计值的平均值E(θ^)=θ,反之为有偏估计量。

渐进无偏估计量:limn→∞E(θ^)−θ=0

有效性标准:若D(θ^1)≤D(θ^2)则θ^1比θ^2更有效。

一致性标准:θ^n⟶Pθ 则称为θ^n是θ的一致估计量。

均方误差标准:E(θ^1−θ)2≤E(θ^2−θ)2则θ^1在均方误差下比θ^2更有效。

具体而言,B2在均方误差下比S2更有效。

区间估计(背)

只针对正态分布

双侧置信

估计μ的(1−α)的置信区间。

若σ2已知,则为(X―−σnu1−α2,X―+σnu1−α2)

若σ2未知,则为(X―−Snt1−α2(n−1),X―+Snu1−α2(n−1))

估计σ2的(1−α)的置信区间。

((n−1)s2χ1−α22(n−1),(n−1)s2χα22(n−1))

单侧置信

估计μ的(1−α)的置信区间。

若σ2已知,则单侧置信下限为X―−σnu1−α,上限为X―+σnu1−α

若σ2未知,则单侧置信下限为X―−Snt1−α(n−1),上限为X―+Snt1−α(n−1)

估计σ2的(1−α)的置信区间。

单侧置信下限为(n−1)s2χ1−α2(n−1),上限为(n−1)s2χα2(n−1)

假设检验

过程

带有概率性质的反证法

  1. 先写出原假设H0和备择假设H1。
  2. 在H0成立的前提下,构造样本满足的分布。
  3. 通过α的值求出对应的拒绝域W。
  4. 代入观测值u,如果u∈W,就拒绝原假设。

弃真取伪及概率计算

第一类错误的概率P1=P(W)小于等于α。

第二类错误的概率为P2=P(W―)。

P1与P2不能同时减小。但可以通过固定其中一个,增加样本量n,减小另一个。具体减小哪一个取决于后果的严重程度。